AI学習は「入手方法」で明暗、Anthropicの15億ドル和解が最終承認
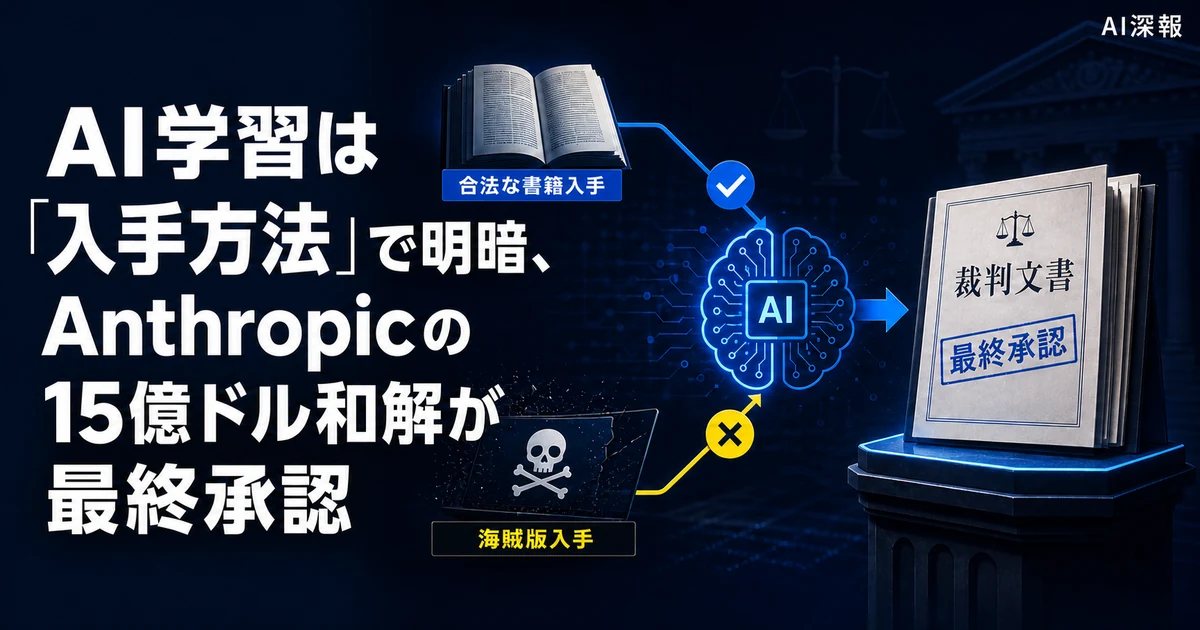
- 米連邦地裁が、Anthropicと作家らの15億ドル(報道換算で約2400億円)の著作権和解を最終承認した
- 裁判では、AIの学習利用と、海賊版サイトから本を入手・保管する行為が別々に判断された
- 会社がAIを作る・追加学習する際は、データの出所と利用許諾を証拠として残す必要がある
何が最終承認されたのか
米カリフォルニア北部地区連邦地裁は2026年7月20日(米国時間)、生成AI「Claude」を開発するAnthropicと作家らの集団訴訟について、15億ドルの和解を最終承認しました。和解サイトに掲載された裁判資料では、返還されない和解基金として15億ドルと利息を用意する枠組みが示されています。
争いの中心は、Anthropicが書籍をClaudeなどの大規模言語モデルの開発に使ったことでした。大規模言語モデルとは、大量の文章から言葉のつながりを学び、質問への回答や文章作成を行うAIの土台です。原告側は、AnthropicがLibrary GenesisやPirate Library Mirrorと呼ばれる海賊版サイトから書籍を入手したとして著作権侵害を訴えていました。
和解の対象は、公式の作品リストに含まれる書籍について、予備承認時点までに主張された過去のダウンロード、共有、スキャン、保管、学習などに関する請求です。今後作られる作品まで自由に使える契約ではありません。また、最終承認は和解条件を裁判所が認めたもので、Anthropicのすべての行為について最終的な違法判決を出したという意味でもありません。
「AIに学習させたから15億ドル」ではない
このニュースで最も誤解しやすいのは、「著作物をAIに学習させる行為が違法と確定し、15億ドルを払うことになった」とまとめてしまうことです。2025年6月の同じ訴訟の判断は、行為を学習、購入本の電子化、海賊版の入手・保管に分けて検討しました。
裁判所は、書籍を使ったAI学習について、元の本と競合する複製物を読者へ配る目的ではなく、新しい文章を生成するモデルを作る変形的な利用だとして、米著作権法上のフェアユースに当たると判断しました。フェアユースとは、目的や市場への影響などを総合し、許可なしの利用を例外的に認める米国の仕組みです。
この命令は、Anthropicによる学習利用についてフェアユースとして略式判決を認める。
出典:米連邦地裁「Order on Fair Use」(原文を日本語訳、和解公式サイト掲載)
一方で、海賊版サイトから何百万冊もの本を無料で取得し、恒久的な電子図書館として保管する行為は別です。裁判所は、将来一部をAI学習へ使う可能性があっても、入手時点の海賊版コピーまでフェアユースで正当化できるとは認めませんでした。この部分が損害額を争う裁判へ進む可能性があり、当事者は15億ドルの和解を選びました。
裁判資料から分かる3つの線引き
AI深報は、フェアユース判断、和解契約、最終承認資料を照合しました。ここから見えるのは、AIの著作権問題を「学習してよいか」の1問だけで考えると判断を誤ることです。少なくとも今回の米国訴訟では、次の3段階が別々に扱われました。
第1は入手です。購入、契約、公開ライセンスなど正規の経路で得たのか、海賊版サイトから得たのかが問われます。第2は保管です。正規に購入した紙の本を検索可能な電子ファイルへ置き換える行為と、海賊版を大量に集めて恒久保存する行為は同じ扱いではありません。第3は利用です。AI学習が変形的な目的でも、その前段階の不正な入手まで自動的に合法になるわけではありません。
つまり、企業が「AI学習はフェアユースだから大丈夫」とだけ確認しても不十分です。学習目的が認められるかと、元データを適法に手に入れたかは別の証明が必要です。今回の和解額が大きくなった背景を理解するには、この分離が重要です。
和解金はどのように支払われるのか
公式FAQによると、Anthropicは15億ドルを4回に分けて基金へ支払います。3億ドルは2025年10月2日に支払い済みとされ、さらに最終承認から5営業日以内に3億ドル、2026年9月25日までに4億5000万ドル、2027年9月27日までに4億5000万ドルを支払う計画です。
対象作品の権利者への配分は、作品ごとの権利関係や有効な請求などを踏まえて管理者が決めます。15億ドルを対象冊数で単純に割った金額が、そのまま全員へ支払われるわけではありません。請求期限は2026年3月30日で終了しており、今回の最終承認を受けて新たな一般受付が始まったわけでもありません。
和解は当事者間の請求を解決する契約です。米国のすべての裁判所や、他のAI企業を拘束する新しい法律ではありません。先のフェアユース判断も米連邦地裁の判断であり、日本の著作権法へそのまま当てはめることはできません。
普通の会社が今から残すべき証拠
自社でAIを一から開発しない会社でも、社内文書を使った追加学習、検索用データベースへの登録、AIサービスへのファイル投入では同じ考え方が役立ちます。重要なのは、データの内容だけでなく、どこから、どの条件で入手し、何に使ったかを後から説明できることです。
具体的には、購入記録、契約書、利用規約、ライセンスの版と確認日、入手元URL、社内の利用目的、削除期限をデータ一覧へひも付けます。外部業者へAI開発を頼む場合は、「使ってよいデータだけを使う」という一文で済ませず、入手元一覧の提出、海賊版や無許諾データの禁止、問題が見つかったときの削除と報告を契約に入れるべきです。
無料で公開されている資料も、自由利用とは限りません。検索で見つかること、ダウンロードできること、AI学習へ使えることは別です。Creative Commonsなどのライセンスがある場合も、商用利用、表示、改変、再配布の条件を確認します。
注意点と限界
この記事は米国の1件の集団訴訟を整理したもので、日本法の結論や個別企業への法律助言ではありません。日本では、情報解析のための著作物利用に関する規定がありますが、権利者の利益を不当に害する場合などの条件があり、今回の米国判断と同じ言葉だけで結論は出せません。
最終承認後も、異議申立てや支払い・配分の実務が続く可能性があります。AI深報は和解公式サイトに掲載された裁判資料とFAQ、2025年のフェアユース判断を確認しましたが、非公開の交渉資料やAnthropic内部のデータ管理記録は確認できません。
今回のニュースから企業が持ち帰るべきことは、AI学習の是非を抽象的に議論するだけでは足りないという点です。データの入手経路と利用条件を記録し、説明できない資料を学習や検索基盤へ入れない運用が、現実的な第一歩です。
※ 本記事は公開時点の一次情報にもとづいています。最新の状況は出典をご確認ください。
AI検索・LLMO対策
月額5万円で、AIに引用される会社へ
AIの進化が速いほど、自社の情報がAIにどう読まれるかも変わります。ChatGPTやGoogleのAI検索で正しく引用される状態を、AIMAが月額5万円でつくります。相談はチャットで回数の制限なし。記事・FAQの制作から公開・保守まで、本数・回数の上限なし。最低契約期間はありません。

監修者:水間 雄紀
株式会社AIMA 代表取締役
1986年和歌山県生まれ、近畿大学卒。金融機関、経営コンサルティング会社を経て、2018年にコンテンツ制作の専門会社である株式会社circlizeを創業。2024年、ラグザス株式会社に事業譲渡。現在は株式会社AIMAにてAI×マーケティング事業に従事し、株式会社ラグザス・クリエイトでコンテンツの品質管理責任者を務める。
監修者・運営会社について