複数PCのGPUを束ねる「Mesh LLM」公開──OpenAI互換APIで分散推論
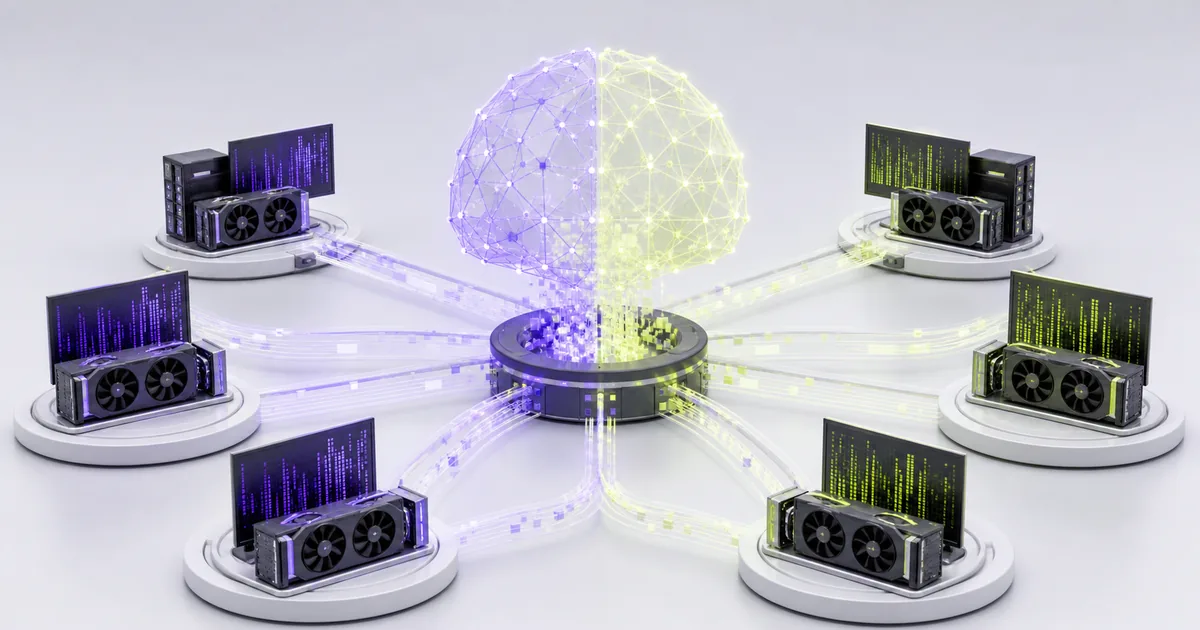
- 複数のパソコンやサーバーにあるGPUとメモリを束ねる「Mesh LLM」が公開された
- 処理は手元の端末、別の参加端末、複数端末への分割の3方式で実行できる
- OpenAI互換APIを使えるが、速度や費用、安全性は利用環境ごとの確認が必要になる
何が発表されたか
分散ネットワーク技術「iroh」の公式ブログは、複数のパソコンやサーバーにあるGPUとメモリをまとめて使う「Mesh LLM」を2026年7月11日に紹介しました。1台では動かしにくい大きなAIモデルを、複数の端末に分けて動かせる仕組みです。
Mesh LLMは、利用者のアプリに対してOpenAI互換APIを提供します。標準的なOpenAIクライアントからローカルのAPIへ接続できるため、アプリ側は処理がどの端末で行われたかを意識せずに利用できると説明されています。
詳細
公式ブログによると、AIへのリクエストは3つの方法で処理されます。1つ目は自分の端末のGPUで動かす方法、2つ目は必要なモデルを読み込み済みの別端末へ送る方法、3つ目は1台に収まらないモデルを層ごとに分け、複数端末を順番につないで動かす方法です。
モデル一覧には40以上のモデルが用意され、5億パラメータ規模から2350億パラメータのMixture-of-Expertsモデルまで含むとされています。ただし、一覧にあるすべてのモデルが、どの端末構成でも同じ速度や品質で動くという意味ではありません。
端末同士の通信にはirohを使います。各端末は公開鍵を本人確認に使い、QUICで直接接続します。直接つながらない場合は中継経路へ切り替える仕組みも用意されています。Mesh LLM側は参加できる端末、互換性のあるバージョン、信頼する相手を管理する独自の情報共有層を持つと説明されています。
利用方法と公開状況
公式ブログでは、約18MBのソフトウェアを導入し、公開メッシュへ参加するか、非公開の構成を設定できると案内しています。APIの接続先はローカルの「localhost:9337/v1」で、一般的なOpenAIクライアントから利用できる設計です。
ソースコードはGitHubで公開されています。公式ブログはモバイルアプリやACPへの対応を今後の計画として説明しているため、これらは現時点で提供済みの機能として扱うべきではありません。
なぜ重要か
会社に余っているGPU搭載パソコンが複数ある場合、1台ずつ別々に使うのではなく、まとまった計算資源として利用できる可能性があります。外部のAI APIだけに頼らず、自社で選んだモデルと機器を使える点は、費用やモデル変更を自分たちで管理したい企業にとって重要です。
一方で、公式ブログだけでは、実際の処理速度、電気代を含む総費用、大人数で使った場合の安定性、企業向けの運用支援までは確認できません。公開メッシュへ接続する場合は、誰の端末で処理されるか、入力データをどこまで共有してよいかも確認が必要です。企業が試すなら、まず機密情報を使わない小さな検証から始め、性能、費用、アクセス制御、ログの扱いを確かめるのが安全です。
※ 本記事は公開時点の一次情報にもとづいています。最新の状況は出典をご確認ください。
AI検索・LLMO対策
月額5万円で、AIに引用される会社へ
AIの進化が速いほど、自社の情報がAIにどう読まれるかも変わります。ChatGPTやGoogleのAI検索で正しく引用される状態を、AIMAが月額5万円でつくります。相談はチャットで回数の制限なし。記事・FAQの制作から公開・保守まで、本数・回数の上限なし。最低契約期間はありません。

監修者:水間 雄紀
株式会社AIMA 代表取締役
1986年和歌山県生まれ、近畿大学卒。金融機関、経営コンサルティング会社を経て、2018年にコンテンツ制作の専門会社である株式会社circlizeを創業。2024年、ラグザス株式会社に事業譲渡。現在は株式会社AIMAにてAI×マーケティング事業に従事し、株式会社ラグザス・クリエイトでコンテンツの品質管理責任者を務める。
監修者・運営会社について