Google DeepMind、AI安全評価を二重盲検に モデルと試験問題を互いに隠す
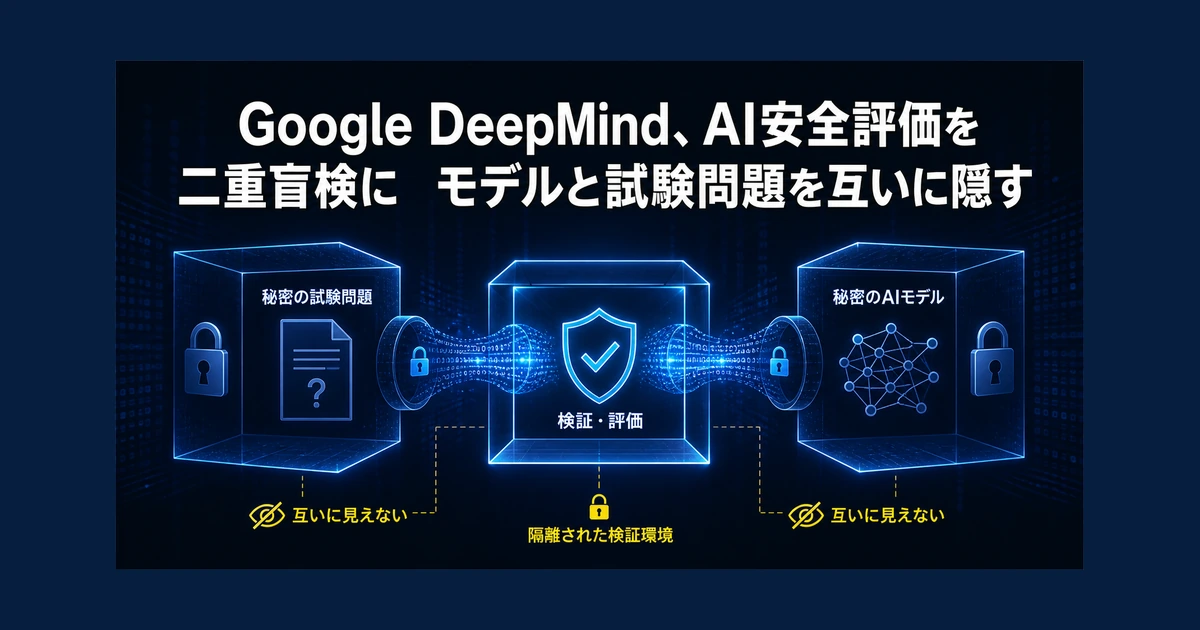
- Google DeepMindは、モデル提供者に試験問題を見せず、評価者にもモデルの中身を渡さない二重盲検のAI安全評価を試行した
- 暗号化された隔離環境でGemini 2.5 Flash Liteと非公開ベンチマークを動かし、双方の秘密を保ったまま結果だけを返す
- 企業はAIの安全性資料を見るとき、点数だけでなく、問題の非公開性、外部評価者、実行環境、未解決の信頼境界まで確認する必要がある
AIの安全点数に『試験問題を見た疑い』を残さない
Google DeepMindは2026年8月27日、フロンティアAIを二重盲検で評価する試行を発表しました。ここでいう二重盲検は、モデル提供者に非公開の試験問題を見せず、評価者にも企業秘密であるモデルの重みを渡さない方法です。両者の資産を暗号化された隔離環境へ入れ、承認した検査だけを実行し、集計結果を外へ返します。
背景にあるのは、AIの評価点をそのまま信じにくくする「ベンチマーク汚染」です。モデルが学習や調整の途中で試験問題を見ていれば、高得点でも未知の問題に強いとは限りません。反対に、評価機関が秘密の問題を守るためモデルの重みを求めれば、開発会社は知的財産や悪用リスクを理由に渡しにくい。この対立を契約だけでなく、暗号とハードウェアで小さくする狙いです。
評価者はGeminiのモデル重みを見られず、Googleも評価者の試験プロンプトを見られない。
出典:Google DeepMind公式発表を要約
秘密のモデルと問題を、一度だけ開く金庫で動かす
試行では、Google DeepMindのGemini 2.5 Flash Liteを、MLCommonsの非公開AILuminate評価とシンガポールAI Safety Instituteの有害内容を引き出す非公開プロンプトで検査しました。協力組織はOpenMined、AI Verification and Evaluation Research Institute(AVERI)、MLCommonsです。実行環境にはGoogle CloudのConfidential Space、Intel TDX、NVIDIA H100 Confidential GPU、OpenMinedのPySyftが使われました。
仕組みは金庫に近いものです。モデル側と評価側は、起動した隔離環境が合意したソフトウェアであることを暗号学的に確認します。その後、モデルの重みと試験問題を暗号化通信で別々に送り、メモリー内でも暗号化したまま評価を実行。許可された集計結果だけを返し、環境は終了時に状態を残しません。技術報告は、一般のAPIへ秘密の問題を送る方式より、将来の学習や調整へ試験内容が混ざる危険を抑えられると説明しています。
| 従来の選択 | 漏れるおそれ | 二重盲検で変わる点 |
|---|---|---|
| 提供会社のAPIで評価 | 非公開の試験問題 | 提供会社から問題を隔離 |
| 評価者へモデルを渡す | 重み・推論コード | 評価者からモデルを隔離 |
| 契約とログ停止で管理 | 誤操作や将来利用 | 実行環境と出力を技術的に制限 |
点数より先に、評価の作り方を調達条件にする
この発表は、新しいGeminiの性能点を示すニュースではありません。技術報告は評価の手順と実証を中心に扱い、今回の安全スコア自体を記事の結論にはしていません。重要なのは、AI会社が自分で選んだ公開問題を解く自己評価から、独立機関が秘密の問題で検査できる土台へ進んだことです。
編集部は、金融、医療、公共分野のように失敗時の損失が大きい導入で、モデル名や総合点だけを比較する時代は終わりに近づくとみます。RFPや稟議では、誰が評価したか、問題がモデル提供者へ見えていたか、評価用モデルと本番モデルが同じか、結果の取り出し方が制限されていたかを尋ねる必要があります。二重盲検が標準化すれば、会社同士で秘密保持契約を結ぶだけだった安全検査に、再確認できる技術的な証拠が加わります。
厳密な外部評価では、試験問題の秘密とモデルの知的財産を同時に守る必要がある。
出典:二重盲検評価の技術報告を要約
暗号化しても、Googleを信頼する部分は残る
今回の仕組みは「誰も信じなくてよい」完全な無信頼方式ではありません。技術報告は、Geminiの推論コードから独自実装をすべて除けず、すべての処理を外部が確認できる状態にはできなかったと明記しています。Confidential Spaceの署名と検証にもGoogleのサービスが入り、個別ビルドは外部で完全に再現できません。評価者のAVERIは制約を知らされたうえで、この構成を受け入れました。
さらに、課題は計算速度より法務合意とコードレビュー、人同士の調整にあると報告されています。大規模なモデルへ広げるには、複数のGPUを暗号化接続する仕組みも必要です。別の評価者が再現できず、評価したモデルと利用者へ提供するモデルがずれるなら、二重盲検という名称だけでは信頼は増えません。今後、評価手順の標準化、複数社での再現、本番版との同一性確認が進むかが分岐点になります。
企業は四つの証拠を同じ表で確認する
高リスク業務でAIを選ぶ会社は、安全性資料を受け取ったら、評価者、試験問題、実行環境、本番との同一性を一枚の表にまとめると判断しやすくなります。「外部評価済み」だけで済ませず、評価者が提供会社から独立しているか、問題が非公開だったか、暗号学的な実行証明があるか、評価後にモデルが更新されていないかを確認します。
現時点で二重盲検は研究試行であり、一般企業が自社契約のモデルへすぐ要求できる標準機能ではありません。それでも、ベンダーへ質問する基準は今日から変えられます。安全点数の高さより、問題漏えいをどう防ぎ、誰がどの版を検査し、どこまで再現できるかを重く見る。そこまで答えられる製品を候補に残すほうが、見栄えのよい単一スコアを比べるより事故を避けやすくなります。
※ 本記事は公開時点の一次情報にもとづいています。最新の状況は出典をご確認ください。
AI検索・LLMO対策
月額5万円で、AIに引用される会社へ
AIの進化が速いほど、自社の情報がAIにどう読まれるかも変わります。ChatGPTやGoogleのAI検索で正しく引用される状態を、AIMAが月額5万円でつくります。相談はチャットで回数の制限なし。記事・FAQの制作から公開・保守まで、本数・回数の上限なし。最低契約期間はありません。

監修者:水間 雄紀
株式会社AIMA 代表取締役
1986年和歌山県生まれ、近畿大学卒。金融機関、経営コンサルティング会社を経て、2018年にコンテンツ制作の専門会社である株式会社circlizeを創業。2024年、ラグザス株式会社に事業譲渡。現在は株式会社AIMAにてAI×マーケティング事業に従事し、株式会社ラグザス・クリエイトでコンテンツの品質管理責任者を務める。
監修者・運営会社について